مكتب محاماة في السعودية عنده منصة انبنت بمنصة توليد تطبيقات بالذكاء الاصطناعي: مساعد ذكي على الموقع يستقبل استفسارات الناس، وبوابة للعملاء، و«مركز ذكاء اصطناعي» للمحامين يصيغ ويحلّل المستندات. المنصة تشتغل، لكن فاتورة التوكنز كل شهر أكبر من اللي يتوقعه المكتب، وما أحد يعرف ليش. نزّلنا تكلفة التوكنز 83%. هذي القصة التقنية: وين كانت تروح التوكنز، وإيش غيّرنا.
باختصار
| قبل | بعد | |
|---|---|---|
| مركز الذكاء الاصطناعي | مفتوح لأي أحد على الإنترنت، بدون تسجيل دخول | لمن عنده صلاحية فقط، مع حد يومي لكل مستخدم وسجل استهلاك |
| أنواع التوليد | نصوص، وصور، وفيديو، وصوت، وتفريغ صوتي، وتحليل PDF | نصوص وتحليل PDF فقط |
| المساعد العام على الموقع | بدون حد للطلبات، والمحادثة كاملة يرسلها المتصفح | 10 طلبات في الدقيقة لكل عنوان، والمحادثة يحفظها الخادم |
| محادثة العميل في البوابة | كل رد ينحفظ بصيغة البث الخام وينرسل من جديد مع كل سؤال | تنقرأ صح، ثم صارت للموظفين فقط |
| الأسئلة المتكررة | كل سؤال يروح للنموذج | ردود تلقائية للأسئلة المتكررة قبل النموذج |
| أسئلة خارج الموضوع | النموذج يجاوب أي شي | سياسة استخدام: المساعد يرد في نطاق الاستشارة القانونية فقط |
| تكلفة التوكنز | أقل بـ 83% |
ليش التكلفة تفلت في التطبيقات المبنية بالذكاء الاصطناعي
أداة التوليد تبني لك ميزة الذكاء الاصطناعي وتخليها «تشتغل»، يعني ترد. لكن ما تسأل: مين يقدر يستدعيها؟ وكم مرة؟ وإيش ينرسل مع كل طلب؟ كل استدعاء للنموذج فلوس، والتطبيق اللي ما يحسب هذي الأسئلة يدفع عن كل زائر، وكل روبوت، وكل سؤال عن الطقس.
وين كانت تروح التوكنز
1. نقاط توليد مدفوعة مفتوحة للعالم
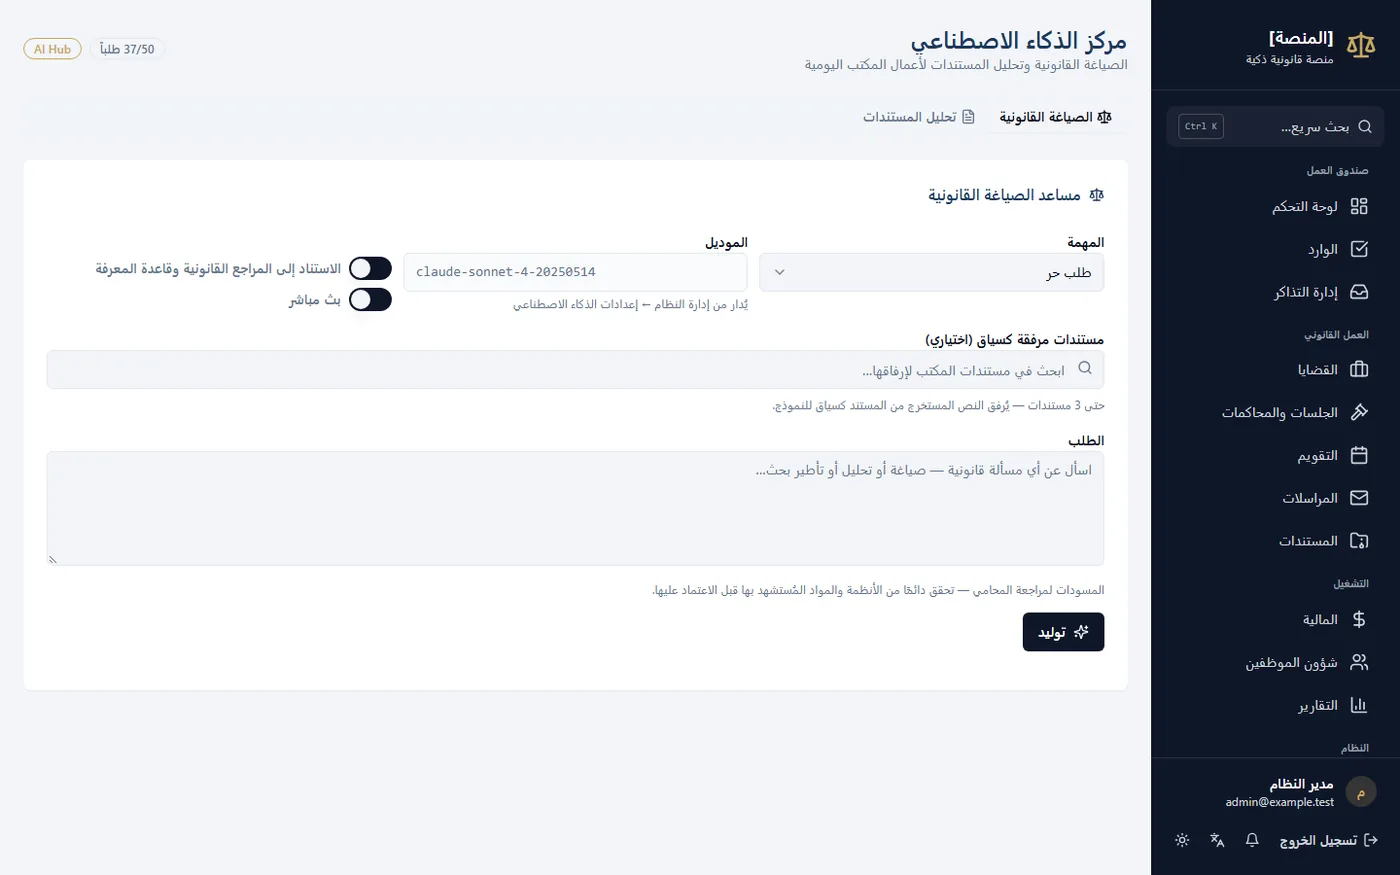
مركز الذكاء الاصطناعي كان فيه نقاط وصول للنصوص والصور والفيديو والصوت وتحليل ملفات PDF لين 80 صفحة. ولا وحدة منها تطلب تسجيل دخول:
router = APIRouter(prefix="/api/v1/aihub", tags=["aihub"])

@router.post("/gentxt")
async def generate_text(request: GenTxtRequest):
    ...
أي أحد يعرف الرابط يقدر يولّد على حساب المكتب، وما فيه سجل يقول مين استهلك إيش. وطلب فيديو كان ممكن يظل يسأل عن النتيجة بدون نهاية.
2. المساعد العام يصدّق اللي يرسله المتصفح
المساعد على الموقع ما يطلب تسجيل دخول، وهذا طبيعي لاستقبال الاستفسارات. المشكلة إن المتصفح هو اللي يرسل المحادثة كاملة مع كل سؤال، والخادم يمرّرها للنموذج كما هي:
max_messages = config.get("max_messages", 20)
if len(data.messages) > max_messages:   # the browser's own array
    raise HTTPException(400, ...)
messages_list = [{"role": "system", "content": system_prompt}]
for msg in data.messages:               # any role, any length
    messages_list.append({"role": msg.role, "content": msg.content})
ما فيه حد لطول الرسالة، ولا حد لعدد الطلبات. والحد «20 رسالة» يفحص المصفوفة اللي أرسلها المتصفح نفسه، فأي أحد يقدر يرسل محادثة طويلة، أو يكتب ردود «المساعد» بنفسه، ويعيد الطلب بلا توقف. وكل هذا على أغلى نموذج، بحد أقصى 4,096 توكن للرد.
3. محادثة البوابة تتضخّم مع كل سؤال
محادثة العميل في البوابة تستقبل الرد بالبث (Streaming)، يعني الرد يجي قطع صغيرة: data: {"content": "..."}. الواجهة كانت تحفظ النص الخام كامل، بكل سطور data: وعلاماتها، كأنه الرد. ومع السؤال الجاي، ترسل المحادثة كلها، بالنص الخام، للنموذج من جديد:
const response = await client.apiCall.invoke({
  url: '/api/v1/ai-legal/chat', method: 'POST',
  data: { messages: newMessages.map(m => ({ role: m.role, content: m.content })) },
});
// Handle non-streaming response
const content = typeof response.data === 'string' ? response.data : ...;
setMessages(prev => [...prev, { role: 'assistant', content }]);
كل رد ينحفظ أطول من حقيقته بأضعاف، وكل سؤال جديد يدفع ثمن كل الأضعاف اللي قبله.
4. كل عميل مسجّل يقدر يستدعي النموذج بلا حد
التسجيل في البوابة مفتوح، ومحادثة العميل وتصنيف الطلبات يكفيها أي حساب. يعني أي أحد يسجّل حساب يصير عنده نموذج ذكاء اصطناعي مجاني على حساب المكتب.
5. أسئلة ما تحتاج نموذج أصلًا
جزء من رسائل المساعد العام أسئلة تتكرر وجوابها ثابت ما يتغيّر، وجزء ثاني ما له علاقة بالمحاماة أصلًا. كل وحدة منها كانت تروح للنموذج وتدفع.
كيف صلّحناه
نقفل المدفوع، ثم نعدّه
router = APIRouter(prefix="/api/v1/aihub", tags=["aihub"],
                   dependencies=[Depends(require_permission("aihub.use"))])

@router.post("/gentxt")
async def generate_text(request, current_user=Depends(get_current_user), db=Depends(get_db)):
    await _enforce_quota(db, current_user)   # 429 over the daily request or token cap
... # a usage row: who, which model, how many tokens- مركز الذكاء الاصطناعي صار لمن عنده صلاحية
aihub.useفقط. - كل طلب ينكتب في سجل استهلاك: المستخدم، والنموذج، وتوكنز الطلب والرد.
- لكل مستخدم حد يومي للطلبات والتوكنز، ولما يوصله يرجع له 429.
- شلنا توليد الصور والفيديو والصوت والتفريغ الصوتي: المكتب ما يحتاجها، وكانت أغلى شي في القائمة.
الخادم يملك المحادثة
allowed, retry_after = ratelimit.check_public_chat(ratelimit.client_ip(request))  # 10 / 60 s / IP
if not allowed:
    raise HTTPException(status_code=429, headers={"Retry-After": str(retry_after)})

existing = await svc.get(cookie_sid) if cookie_sid else None   # HttpOnly cookie, not the body
prior_turns = ChatSessionService.transcript_of(existing) if existing else []
if len(prior_turns) + 1 > max_messages:                         # counted on the server's copy
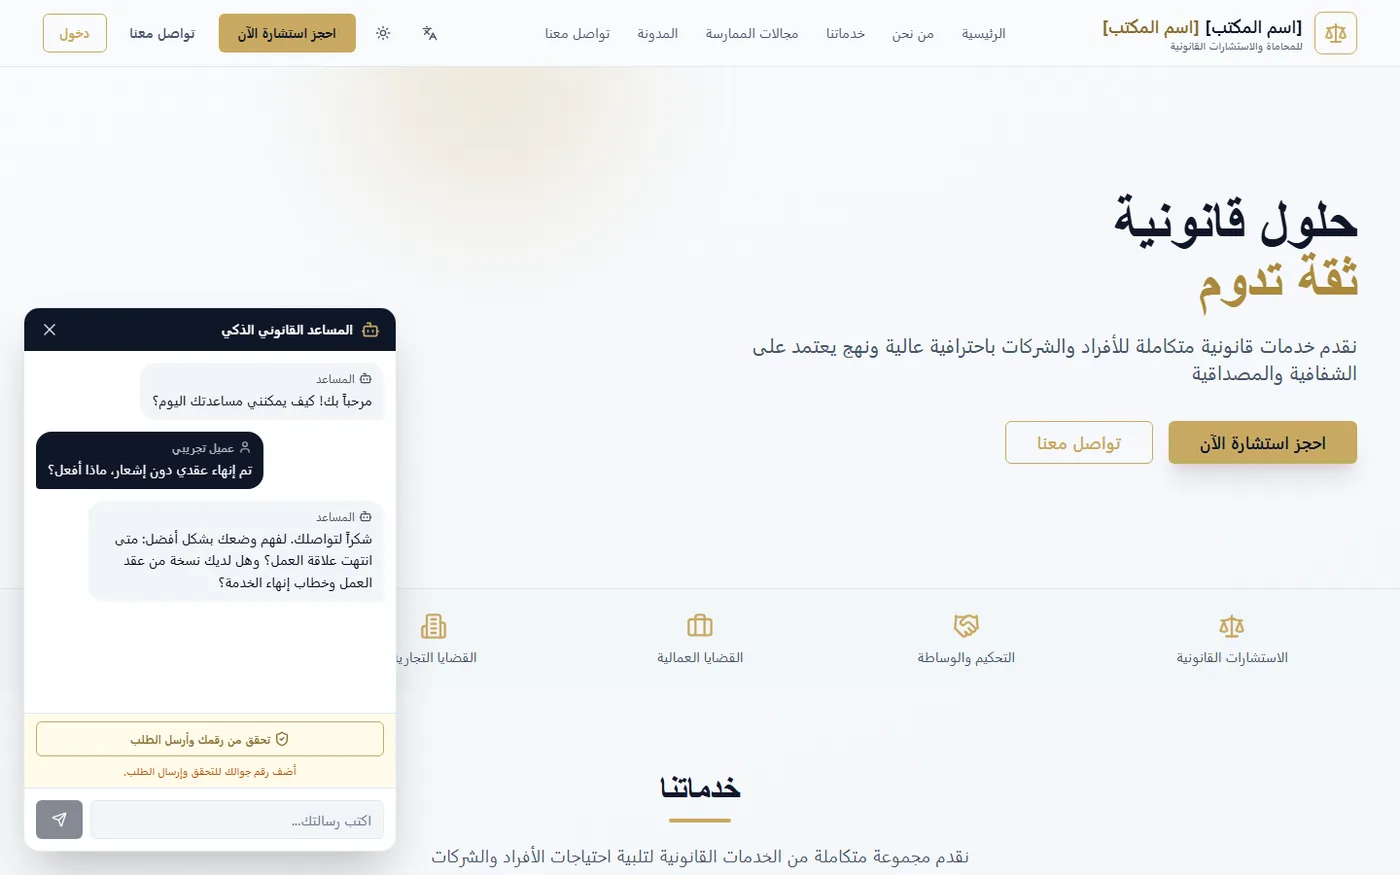
raise HTTPException(status_code=400, ...)- المتصفح الحين يرسل رسالة وحدة بس، مو المحادثة كاملة.
- المحادثة ينحفظها الخادم، ومنها يبني اللي ينرسل للنموذج. ما عاد أحد يقدر يكتب ردود «المساعد» بنفسه أو يضخّم المحادثة.
- 10 طلبات في الدقيقة لكل عنوان، وحد 20 رسالة ينعدّ على نسخة الخادم.
ردود تلقائية قبل النموذج
الأسئلة المتكررة صار لها ردود جاهزة يكتبها المكتب ويعدّلها بنفسه. إذا السؤال منها، الرد يطلع على طول بدون ما يلمس النموذج. النموذج يشتغل بس لما يكون فيه شي يستاهل: قضية تحتاج فهم.
سياسة استخدام للمساعد
المساعد العام له نطاق واحد: يفهم مشكلة الزائر القانونية ويجمع اللي يحتاجه المحامي. أي سؤال برا النطاق، مثلًا واجب مدرسي أو ترجمة أو كود، يرد عليه برد قصير ثابت يرجّعه للموضوع، بدل ما يكتب له صفحة.
البث ينقرأ صح، والبوابة للتذاكر
const lines = buffer.split('\n'); buffer = lines.pop() ?? '';
for (const line of lines) {
  if (!line.startsWith('data: ')) continue;
  const payload = line.slice(6);
  if (payload === '[DONE]') { done = true; break; }
  const parsed = JSON.parse(payload);
  if (parsed.content) assistantContent += parsed.content;
}
صلّحنا قراءة البث أول، فصار الرد ينحفظ نص نظيف. وبعدها المكتب قرّر إن تواصل العميل يكون عبر تذاكر يرد عليها محامي، فصارت محادثة الذكاء الاصطناعي وتصنيف الطلبات للموظفين فقط.
كيف تأكدنا
- اختبارات تتأكد إن حساب العميل يرجع له 403 من محادثة الذكاء الاصطناعي، وإن المساعد العام يتجاهل أي ردود «مساعد» يرسلها المتصفح، وإن الطلب رقم 11 في الدقيقة يرجع 429، وإن الحد اليومي يوقف المستخدم ويسجّل التوكنز.
- سجل الاستهلاك صار يقول مين يستهلك إيش، فالمكتب يشوف أي ارتفاع أول بأول.
- والنتيجة على الفاتورة: تكلفة التوكنز نزلت 83%.
المدة
12 يوم، من إقفال مركز الذكاء الاصطناعي في أول يوم، لين صارت محادثة الذكاء الاصطناعي للموظفين فقط.
إذا منتجك فيه ذكاء اصطناعي
- كل نقطة وصول تستدعي نموذج: مين يقدر يستدعيها بدون تسجيل دخول؟
- إيش ينرسل للنموذج مع كل طلب؟ إذا المتصفح يرسل المحادثة كاملة، الخادم لازم ما يصدّقها.
- فيه حد للطلبات وحد للطول، على الخادم مو على الواجهة؟
- تقدر تقول كم توكن استهلك كل مستخدم أمس؟ إذا لا، ما تقدر تعرف وين تروح فلوسك.
- كم سؤال من اللي توصلك له رد ثابت؟ هذا ما يحتاج نموذج.
إذا فاتورة الذكاء الاصطناعي عندك تكبر وما تدري ليش، اقرأ فاتورة كبيرة بسبب مفتاح مسرّب وخطأ OpenAI 429. وإذا تبي أحد يلقى السبب ويقفله، الإصلاح المباشر، أو ابدأ بـ تدقيق جاهزية الإطلاق.